Как создать ИИ-агента: пошаговое руководство с примерами для новичков
Маркетолог просит нейросеть ответить на вопрос клиента, и ответ звучит правдоподобно. Проблема начинается, когда нужно не ответить, а сделать: проверить заказ в учётной системе, найти клиента в CRM, поставить задачу менеджеру, отправить счёт. Модель, которая умеет только говорить, здесь останавливается — у неё нет доступа к рабочим системам, и кто-то должен вручную перенести её ответ в нужное окно.
Именно на этом шаге появляется ИИ-агент — программа на основе языковой модели, которая получает цель, сама выбирает последовательность действий и вызывает нужные инструменты. Ниже — как такой агент устроен, из чего состоит, где применяется в маркетинге и продажах и как собрать первого агента по шагам, от постановки задачи до запуска.
Основные понятия и определения
- ИИ-агент (AI Agent). Программа на основе языковой модели, которая получает цель, планирует шаги, вызывает инструменты и доводит задачу до результата.
- Языковая модель (LLM). Модель, обученная на больших объёмах текста; понимает формулировки и генерирует ответы, но сама по себе не выполняет действий.
- Системный промпт (инструкция агента). Задание роли, цели, правил и ограничений, которое модель получает до начала работы.
- Короткая память. История текущего диалога или задачи, которую модель видит при каждом шаге.
- Длинная память. Внешняя база знаний: регламенты, прайсы, описания продуктов, частые вопросы.
- База знаний. Подготовленный набор документов, по которому агент ищет ответы вместо того, чтобы придумывать их.
- Инструменты агента. API-подключения, вебхуки, поиск, работа с файлами и базами данных — то, чем агент действует.
- ReAct. Схема работы агента в цикле «мысль → действие → наблюдение»: сначала план, потом вызов инструмента, потом разбор результата.
- Автономный агент. Агент, который выполняет цепочку шагов без участия человека и обращается к нему только в узких границах.
- Мультиагентная система. Несколько агентов с разными ролями, которые обмениваются результатами работы.
- No-code и low-code. Способы собрать агента визуально, из готовых блоков, без программирования или с минимальным кодом.
- Вебхук. Автоматический запрос, которым одна система сообщает другой о событии, например о новой заявке.
Суть за минуту
ИИ-агент отличается от чат-бота тем, что действует, а не только отвечает: у него есть цель, инструкция, память и подключённые инструменты. Собрать первого агента можно без кода на платформе вроде n8n, Yandex AI Studio или Botpress. Начинают с одной узкой задачи, затем пишут инструкцию с ограничениями, подключают базу знаний и один-два инструмента, после чего тестируют на реальных запросах и только потом расширяют автономию.
Что такое ИИ-агент и чем он отличается от чат-бота
ИИ-агент — это языковая модель, у которой есть инструменты и цикл принятия решений. Обычный чат-бот отвечает текстом, собранным из того, что модель знает или получила в промпте, и на этом его участие заканчивается. Агент идёт дальше: он разбирает задачу на шаги, решает, какой инструмент вызвать, и выполняет действие — обращается к API, базе данных или внешнему сервису.
Разницу проще увидеть на одном вопросе. Клиент спрашивает, где его заказ. Чат-бот отвечает общей фразой про сроки доставки и предлагает обратиться в поддержку. Агент находит клиента в базе, смотрит статус отправления, сверяет дату предыдущего обращения и присылает точный ответ, а при задержке сам создаёт черновик задачи менеджеру — отправит её человек после проверки.
Ключевое отличие: действие вместо ответа
Главное различие в объёме ответственности. Чат-бот удерживает тему разговора и выдаёт текст, но всё, что происходит после ответа, делает человек. Агент работает до результата: заявка попадает в CRM, письмо уходит, запись появляется в календаре.
Из этого следует важное ограничение. Чем больше действий доступно агенту, тем строже нужно ограничивать его права. Возможность обратиться к базе данных — сила, но та же возможность, выданная без правил, превращается в риск.
Когда агент не нужен
Не всякую задачу стоит отдавать агенту. Если действия идут в жёстком порядке и от раза к разу повторяются — например, принять заявку и переслать её в отдел, — хватает обычного сценария автоматизации с одним вызовом модели или вообще без неё.
Агент оправдан там, где состав шагов заранее неизвестен: клиент пишет по-разному, вопросы разной глубины, ответ зависит от данных из нескольких систем. Тогда решение «куда посмотреть и что вызвать» дешевле отдать модели, чем описывать сотню ветвлений вручную.
Как работают автономные ИИ-агенты
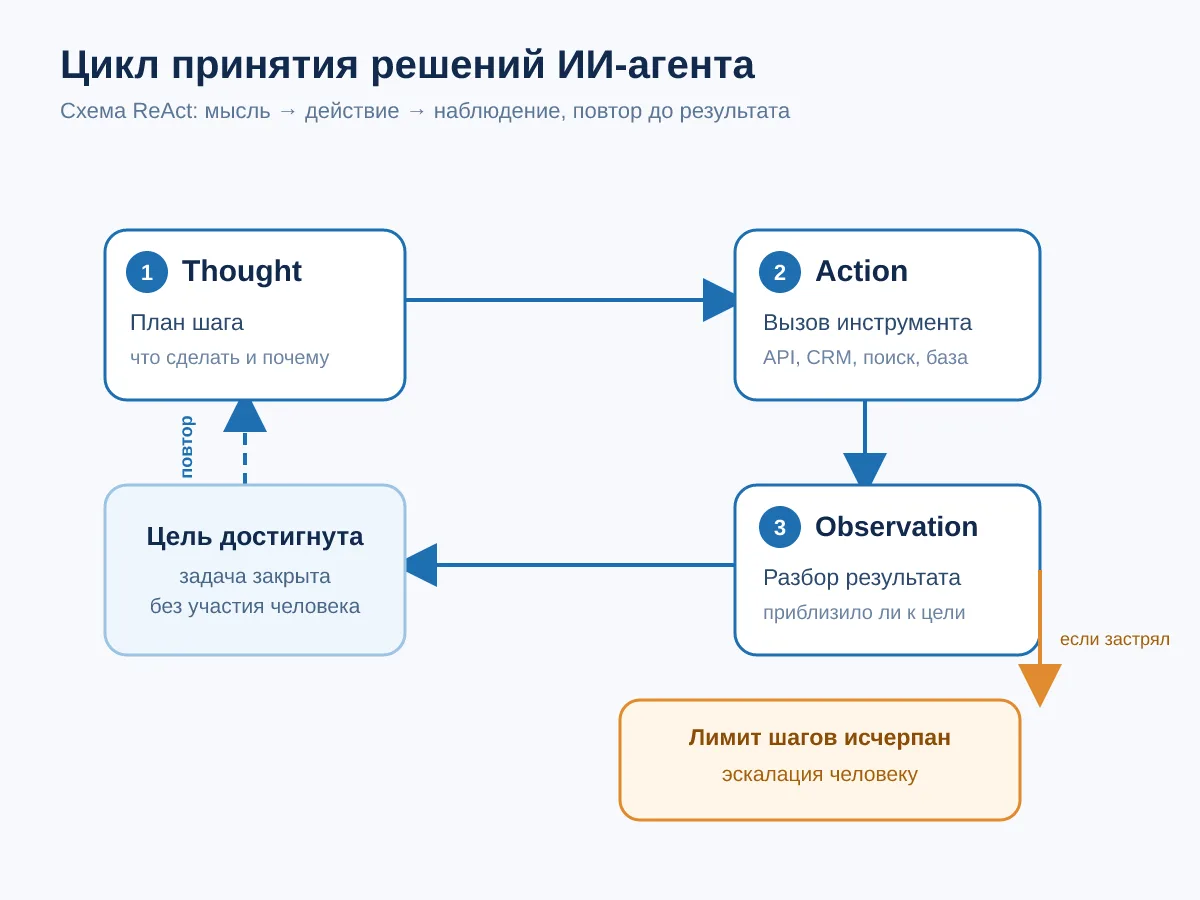
Автономный агент не выполняет задание одной командой. Он работает циклом: получает цель, оценивает, чего не хватает для её достижения, вызывает инструмент, смотрит на результат и снова решает, что делать дальше. Цикл повторяется, пока задача не закрыта или пока агент не упрётся в ограничение, которое ему задали.
Именно цикл превращает модель из собеседника в исполнителя. Если ответ инструмента оказался неполным, агент не сдаётся сразу, а уточняет запрос или выбирает другой источник. Если действие привело к ошибке, он видит её в результате и меняет подход.
Цели, инструменты и память агента
Работа начинается с цели: что считать выполненным. Формулировка «помочь клиенту» слишком размыта, а «найти заказ, сообщить срок и при задержке открыть обращение» задаёт понятный критерий готовности.
Дальше вступают инструменты и память. Инструменты дают агенту руки, память — контекст: что уже было сказано в этом диалоге и что известно из базы знаний компании. Без первого агент остаётся советчиком, без второго — каждый раз начинает с нуля и повторяет ошибки.
Цикл принятия решений: Thought → Action → Observation
Этот цикл известен как ReAct и состоит из трёх шагов. Thought — агент формулирует, что нужно сделать и почему. Action — вызывает конкретный инструмент с нужными параметрами. Observation — читает ответ и оценивает, приблизил ли он к цели.
Пример: клиент просит подобрать тариф. Агент думает, что для ответа нужны условия из базы знаний; вызывает поиск по документам; получает выдержку, но видит, что не хватает данных о профиле клиента; вызывает запрос в CRM; и только после этого собирает ответ. Если промежуточный результат неполон, цикл повторяется с новым шагом.
Практический ориентир: число шагов цикла ограничивают. Для типовой задачи с одним-двумя инструментами обычно хватает трёх-четырёх вызовов, поэтому в инструкции задают лимит в десять итераций — это запас на случай, когда первый ответ инструмента неполный. Если агент уходит в повтор — третья и четвёртая попытки возвращают тот же пустой ответ, — лимит обрывает цикл, и обращение переходит человеку.
Из чего состоит ИИ-агент
Устройство агента удобно разложить на четыре части: модель, инструкцию, память и инструменты. Каждая отвечает за своё, и ошибка в любой из них ломает работу целиком. Модель без инструкции отвечает общими словами, инструкция без инструментов не даёт действовать, инструменты без памяти заставляют повторять одно и то же.
Ниже — что делает каждая часть и на что смотреть при настройке. Этот разбор нужен до выбора платформы: понимая состав, легче понять, какие функции ищут в конструкторе.
Языковая модель (LLM)
Модель — это «мозг» агента. Она понимает запрос, решает, какой шаг сделать следующим, и формулирует текст ответа. От неё зависит качество рассуждений, знание языка и умение работать с инструментами.
Выбор модели — компромисс между качеством, скоростью и ценой за обращение. Для простых классификаций и черновиков хватает лёгких моделей, для сложных сценариев с несколькими инструментами — более сильных. Через API доступны разные провайдеры, например DeepSeek API, GigaChat API и модели Yandex AI Studio.
Системные инструкции
Системный промпт — это должностная инструкция агента. В нём описывают роль, задачу, тон, доступные источники и, что важнее всего, запреты: чего агент не делает, когда останавливается и в каких случаях зовёт человека.
Хорошая инструкция конкретна и коротка по смыслу: кто агент, для кого работает, что считает успехом, что делать при неуверенности. Размытые формулировки модель трактует по-своему, и поведение становится непредсказуемым.
Память: короткая и длинная
Короткая память — история текущего диалога или задачи. Её модель получает при каждом ответе, чтобы не переспрашивать одно и то же. Когда диалог разрастается, историю сокращают или суммируют, иначе окно контекста переполняется.
Длинная память — база знаний компании: регламенты, прайсы, описания услуг, разобранные обращения. Её загружают заранее, и агент обращается к ней при необходимости. Разделение важно: без короткой памяти агент теряет нить разговора, без длинной — уверенно выдумывает факты.
Инструменты и база знаний
Инструменты — то, чем агент действует: запросы к API, вебхуки, поиск, чтение файлов, запись в базу. Каждый инструмент описывают так, чтобы модель понимала, когда и с какими параметрами его вызывать.
Важно: инструменты выдают по минимально нужным правам. Если агенту достаточно читать заказы, не давайте ему возможность их менять. Это обычная практика безопасности: сбой в рассуждении агента не должен превращаться в испорченные данные.
Способы создания: no-code, low-code или код
Способ сборки выбирают по задаче и навыкам команды, а не по популярности платформы. Кто-то собирает рабочего агента за вечер в визуальном конструкторе, кому-то нужен полный контроль над логикой и состояние задачи между шагами — тогда без кода не обойтись. Ошибка в выборе подхода стоит дорого: на конструкторе сложный агент упрётся в ограничения, а на коде простой агент потребует разработчика ради пары действий.
Ниже — три подхода с честными границами применения. Таблица сравнения показывает, как они соотносятся по сложности, гибкости и подходящим сценариям.
Сравнение подходов к сборке агента
| Подход | Кому подходит | Гибкость | Типичные сценарии |
|---|---|---|---|
| No-code платформы | Маркетологам и специалистам поддержки без навыков программирования | Ограниченная настройками сервиса | Агент поддержки по базе знаний, квалификация заявок, автопостинг |
| Low-code и оркестраторы | Командам с базовым техническим опытом | Средняя: логика из блоков и ветвлений | Агент с несколькими интеграциями, суммаризация, сбор данных |
| Разработка на Python или JavaScript | Разработчикам и техническим командам | Полная: своя логика, контроль состояния | Агент внутри продукта, сложные интеграции, приватность данных |
| Фреймворки (LangChain, LlamaIndex, AutoGen, CrewAI) | Командам, которые строят несколько агентов и сложные цепочки | Полная, но требует архитектурных решений | Мультиагентные системы, агенты с большим объёмом документов |
Вывод из таблицы практический: для первого агента почти всегда разумнее начать сверху вниз. Проверьте сценарий на конструкторе, убедитесь, что задача действительно требует агента и приносит пользу, и только после этого думайте о коде. Переписать работающий сценарий на фреймворке проще, чем объяснить руководству, зачем нужна разработка проекта, который не запустили.
No-code и low-code платформы
Визуальные конструкторы дают агента без программирования: выбираете модель, вставляете инструкцию, подключаете базу знаний и готовые интеграции через интерфейс. К популярным вариантам относятся n8n, Flowise, Botpress и Voiceflow, а облачные платформы вроде Yandex AI Studio предлагают создать агента в отдельном разделе и сразу получить доступ к API.
Граница такого подхода — нестандартная логика. Если сценарий требует сложной обработки ошибок, собственной очереди задач или необычной интеграции, конструктор упирается в свои ограничения. До этого момента он экономит недели работы и позволяет маркетологу править поведение агента самому.
Разработка на Python и JavaScript
Код даёт полный контроль: своя логика ветвления, хранение состояния, обработка ошибок, тонкая настройка промптов и вызовов инструментов. Язык выбирают по стеку команды — для большинства агентных задач подходят обе экосистемы, у Python шире выбор библиотек для работы с моделями и данными.
Разработка оправдана, когда агент становится частью продукта, а не внутренним ботом. Тогда нужны тесты, версионирование промптов, логирование действий и понятный процесс выкатки изменений. Это уже проект с инженерной поддержкой, а не настройка на вечер.
Фреймворки (LangChain, LlamaIndex, AutoGen, CrewAI)
Фреймворки дают готовые строительные блоки: связку модели с инструментами, работу с документами, управление цепочками шагов и построение нескольких агентов. LangChain и LangGraph удобны для оркестрации шагов и состояния, LlamaIndex — для поиска по большому объёму документов, AutoGen и CrewAI рассчитаны на командную работу агентов с разными ролями.
Смысл фреймворка — не написать меньше строк, а получить проверенные решения типовых узлов. При этом наборы функций у LangChain и LlamaIndex заметно пересекаются: загрузка документов, поиск и связка с инструментами есть в обоих. Выбор чаще упирается не в наличие функции, а в её специализацию — LangChain удобнее для оркестрации шагов, LlamaIndex — для поиска по большому объёму документов. И новая зависимость означает новую ответственность: обновления ломают совместимость, а абстракции фреймворка иногда мешают, когда нужно докопаться до конкретного вызова.
Где ИИ-агенты применяются в маркетинге
В маркетинге агенты закрывают участки, где нужно не просто сгенерировать текст, а выполнить действие: собрать данные, разложить материал по площадкам, квалифицировать обращение, обновить запись. Это то, чего не хватало обычным нейросетям — они помогали думать, но не помогали делать.
Ниже — три направления, где эффект заметен быстрее всего. Каждое начинается с повторяющейся операции, которую легко измерить до и после запуска агента.
Ежедневные операции маркетолога
Больше всего времени у маркетолога уходит не на творчество, а на сбор и перенос данных. Ежедневно нужно свести показатели кампаний из рекламных кабинетов, сверить расход с планом, достать из веб-аналитики цифры по источникам и вручную перенести их в таблицу или отчёт. Каждая операция занимает минуты, но в сумме съедает часть рабочего дня.
Агент забирает именно эту рутину. Он сам запрашивает данные по расписанию, собирает их в один отчёт, помечает кампании, где расход ушёл вперёд плана или показы просели, и присылает маркетологу короткую сводку с отклонениями. Человек приходит к готовым цифрам и занимается решениями: что менять в ставках, какие объявления переписать, куда перенести бюджет.
Как сравнить эффект: до агента замерьте, сколько времени в день уходит на сверку и сбор отчёта и сколько ошибок в числах находится при проверке. После запуска сравните те же показатели за тот же период. Если время сократилось, а расхождения в отчётах исчезли, агент закрывает свою задачу.
Контент и соцсети
Агент для контента работает с одним материалом и превращает его в единицы под разные каналы: статью — в пост для соцсети, вебинар — в тезисы, кейс — в короткую заметку. Он подбирает заголовки, готовит описания и метаданные, ставит публикации в очередь по календарю.
Важная граница — смысл и экспертность. Агент ускоряет подготовку, но перед публикацией редактор проверяет то, что модель подставить не может: точность фактов и цифр, уместность обещаний, соответствие голосу бренда. Если пустить агента писать от себя, тексты быстро становятся одинаковыми и теряют детали, которые отличают компанию от конкурентов.
Реклама и аналитика
В рекламе агент подходит для рутинных сверок: собрать показатели с нескольких площадок, сопоставить с планом, отметить отклонения и подготовить сводку. Отдельная роль — контроль бюджета: агент сверяет дневной расход с лимитом по каждой кампании, а не только собирает сводку. Если ставка или расход выходит за заданную рамку, он сообщает ответственному, но сам их не меняет — изменение бюджета остаётся решением маркетолога.
В аналитике агент отвечает на вопросы к данным: «какие кампании просели за неделю», «откуда пришли заявки». Это удобнее готового дашборда, потому что вопрос можно сформулировать обычными словами. Но выводы он делает по данным проекта, а не по общим представлениям, и это надо явно прописать в инструкции.
Продажи и поддержка клиентов
Самый частый сценарий для бизнеса — агент поддержки клиентов. Он отвечает по базе знаний, уточняет вопрос, находит клиента в CRM и передаёт историю менеджеру вместе с контекстом. Для продаж агент квалифицирует обращения: выявляет потребность, задаёт уточняющие вопросы, фиксирует лид и ставит задачу ответственному.
Эффект здесь накопительный. Один пропущенный вопрос не проблема, но при потоке обращений ответы без задержки и без потери заявок меняют картину. Агент не заменяет менеджера, а снимает с него повторяющиеся вопросы и не даёт обращениям висеть без ответа.
Примеры ИИ-агентов для бизнеса
Проще понять пользу агентов на типах задач, а не на названиях платформ. Разные роли требуют разного набора инструментов: где-то нужен только поиск по документам, где-то — запись в CRM и календарь. Таблица ниже помогает соотнести тип агента с задачей и уровнем автономии.
Ниже — четыре базовых типа и мультиагентная система. Многие проекты начинаются с одного типа и со временем разрастаются до связки.
Типы ИИ-агентов по уровню автономии
| Тип агента | Что делает | Нужные инструменты | Уровень автономии |
|---|---|---|---|
| Реактивный | Отвечает на вопросы по базе знаний и часто задаваемым темам | Поиск по документам, база знаний | Низкий: отвечает, передаёт человеку |
| Квалификатор | Выявляет потребность и передаёт лид в CRM | CRM, форма, календарь | Средний: задаёт вопросы и фиксирует данные |
| Планировщик | Согласует время и создаёт записи в календаре | Календарь, CRM, уведомления | Средний: бронирует слоты в заданных правилах |
| Консультант | Подбирает решение по параметрам из базы знаний | База знаний, справочники, калькулятор | Средний: предлагает, финальное решение за человеком |
| Мультиагентная система | Несколько агентов делят роли и собирают общий результат | Набор инструментов у каждого агента | Высокий: требует строгих ограничений |
Вывод из таблицы: чем выше автономия, тем больше требований к правилам и тестированию. Начинать имеет смысл с реактивного агента или квалификатора — там ошибка дешевле, а польза видна уже на первых сотнях обращений.
Типы агентов: реактивный, квалификатор, планировщик, консультант
Реактивный агент ближе всего к чат-боту: он отвечает по базе знаний и передаёт сложные вопросы человеку. Квалификатор уже ведёт диалог с целью: уточняет потребность, фиксирует данные и уходит вместе с лидом в CRM. Планировщик согласует время встречи и создаёт запись в календаре, а консультант подбирает решение по параметрам — например, тариф или конфигурацию услуги.
Различия не столько в технологии, сколько в объёме прав. Реактивному достаточно чтения, квалификатору и планировщику нужно записывать данные. Чем больше таких прав, тем важнее проверки: агент не должен создать дубль лида или поставить встречу на уже занятое время.
Мультиагентные системы
Если задача распадается на разные роли, её делят между несколькими агентами. Один ищет информацию в документах, другой пишет текст, третий проверяет данные и собирает итог. Такой подход используют в сложных процессах, например при подготовке аналитического отчёта или обработке большого объёма заявок.
Плата за гибкость — сложность управления. Агенты могут расходиться в выводах, зацикливаться на передаче задачи друг другу или терять детали. Поэтому в мультиагентной системе критичны общий формат обмена результатами и явные правила, кому отдаётся финальное слово.
Как создать ИИ-агента: пошаговый план
Создание агента — это не одна настройка, а последовательность из пяти шагов. Каждый следующий опирается на предыдущий: без понятной задачи нечего выбирать, без выбранной платформы некуда писать инструкцию, без тестов рано запускать. Пропуск шага почти всегда возвращает к нему позже, только уже с испорченным результатом.
План ниже рассчитан и на no-code, и на код — меняются инструменты, но порядок остаётся. Если проходить шаги по очереди, первый рабочий агент появляется быстрее, чем при попытке собрать всё сразу.
Шаг 1. Постановка задачи и границ агента
Начинают с описания задачи в терминах результата: что должно измениться в системе или в работе человека после действия агента. «Отвечать клиентам» — слабая формулировка. «Найти заказ по номеру, сообщить статус и при задержке открыть обращение» — рабочая, потому что у неё есть проверяемый итог.
Сразу же очерчивают границы: какие темы агент не обсуждает, что делает при неуверенности, когда передаёт человеку, какие данные получать не должен. Совет: пропишите примеры запросов, которые агент обрабатывает, и примеры, которые обязан отклонить. Это будущие тесты.
Шаг 2. Выбор платформы и модели
Платформу выбирают по задаче и команде: визуальный конструктор, если нужен результат быстро и без разработчика; оркестратор, если важны интеграции; код или фреймворк, если агент встраивается в продукт. Проверьте заранее, есть ли у платформы нужные интеграции и доступ к выбранной модели.
Модель подбирают под тип работы. Для классификации и коротких ответов хватает быстрой и недорогой модели, для сложных рассуждений с инструментами нужна более сильная. Сравните варианты на своих примерах из первого шага — это надёжнее, чем ориентироваться на общие рейтинги.
Шаг 3. Инструкция, память и инструменты
Инструкцию пишут как должностную: роль, цель, тон, правила, запреты, сценарий эскалации. Дальше загружают базу знаний — регламенты, прайсы, частые вопросы — и подключают инструменты с минимально нужными правами.
Отдельно настройте память. Определите, что агент помнит в рамках диалога, что берёт из базы знаний и как долго хранить историю обращений. Важно: ключи доступа к API хранят в переменных окружения, а не в коде и не в тексте инструкции — иначе они утекают вместе с настройками.
Шаг 4. Тестирование и оценка качества
Тестируют на реальных запросах, а не на придуманных идеальных формулировках. Собирают выборку из живых обращений, включая неудобные: опечатки, смешанные вопросы, просьбы о скидке, попытки выведать данные. Смотрят, где агент отвечает неверно и принял бы опасное действие.
Метрики простые: доля корректных ответов, доля случаев, переданных человеку, число неудачных вызовов инструментов. По ним видно, где проблема — в инструкции, в базе знаний или в модели. Правки вносят по одной, иначе непонятно, что дало эффект.
Шаг 5. Запуск и развитие агента
Запускают в узком контуре: одна тема, один канал, ограниченная доля обращений. Все действия агента логируют, чтобы разбирать ошибки. Расширение начинают после того, как на пилоте набралась статистика и команда понимает поведение агента.
Развитие не заканчивается запуском. База знаний устаревает, меняются продукты и правила, появляются новые типы запросов. Поэтому агента регулярно проверяют на свежих обращениях и обновляют инструкцию — иначе качество потихоньку проседает.
Типичные ошибки при создании ИИ-агента
Большинство проблем первого агента возникает не из-за модели, а из-за подготовки. Ниже — ошибки, которые встречаются чаще всего, и что с ними делать. Каждая из них проявляется уже на тестах, если их проводить на реальных запросах.
Список стоит держать перед глазами на этапе настройки, а не после запуска: исправлять поведение агента, когда он уже работает с клиентами, дороже и рискованнее.
- Слишком широкая задача. Агент «на все случаи» расплывается в ответах и ошибается чаще. Начните с одной узкой цели и расширяйте после стабильного результата.
- Размытая инструкция. Общие слова про «качественный сервис» модель понимает по-разному. Пропишите конкретные правила, запреты и сценарий передачи человеку.
- Пустая или устаревшая база знаний. Агент отвечает уверенно и неверно, потому что ему нечего искать. Загружайте актуальные документы и обновляйте их вместе с прайсами и регламентами.
- Избыточные права инструментов. Агент с доступом к записи и удалению может навредить при сбое. Выдавайте только те действия, без которых задача не решается.
- Тесты на идеальных запросах. В реальности клиенты пишут с ошибками и путают темы. Тестируйте на живых обращениях, включая провокационные.
- Отсутствие эскалации. Агент, который не умеет звать человека, доводит спорный вопрос до ошибки. Определите чёткие условия передачи оператору.
Риски и ограничения автономных агентов
Автономия — главный источник и пользы, и риска. Чем больше шагов агент делает без проверки, тем заметнее становится ошибка: одна неверная догадка превращается в цепочку действий. Поэтому к автономным агентам предъявляют те же требования, что к любому исполнителю с доступом к системам.
Риски делятся на три группы — безопасность доступа, качество решений и ответственность за результат. Разбирать их лучше до запуска, потому что потом часть ограничений уже нельзя добавить без переделки.
- Доступ к внешним системам. Агенту жёстко ограничивают права и список сервисов, к которым он обращается. Ненужные интеграции — лишняя поверхность для сбоя.
- Утечка ключей и данных. API-ключи не хранят в коде, не публикуют и не пересылают в открытом виде. Персональные данные клиентов обрабатывают по правилам компании.
- Ошибочные действия. Необратимые операции — оплату, удаление, отправку массовой рассылки — ставят под подтверждение человека.
- Галлюцинации. Без базы знаний агент отвечает правдоподобно и неточно. Ответы по фактам сверяют с документами, а не с памятью модели.
- Зацикливание и расходы. Лимит шагов нужен не для нормальной задачи, а для сбоя. Если инструмент снова и снова возвращает пустой или ошибочный ответ, агент повторяет вызов, и каждый повтор — это новый расход. Поэтому в инструкции задают тот же предел в десять итераций: на типовой сценарий его с запасом хватает, а на повторном цикле он срабатывает и передаёт задачу человеку. Дополнительно ограничьте стоимость одной задачи, чтобы неудачный прогон не превращался в неожиданный счёт.
- Прозрачность для клиента. Человек должен понимать, что общается с автоматикой, и иметь путь к живому сотруднику.
Вывод: безопасность агента — это набор правил и ограничений, а не одна настройка. Права, лимиты, подтверждения и эскалация настраиваются вместе на этапе проектирования.
Чек-лист: как проверить агента перед запуском
Чек-лист помогает не забыть то, что легко упустить при настройке. Пройдите по пунктам до того, как агент начнёт работать с реальными клиентами. Если какой-то пункт вызывает сомнение, лучше сначала закрыть его, а потом запускать.
Проходить чек-лист нужно именно до запуска: после того как агент начал работать с реальными клиентами, каждое исправление обходится дороже. Если какой-то пункт не закрыт, останавливайте запуск и закрывайте его: непрописанные границы и устаревшая база знаний превращаются в ошибки на живых обращениях. Пункт, который невозможно выполнить сейчас, означает не «отложить всё», а сузить первый запуск — одна тема, один канал, ограниченная доля обращений.
- Задача сформулирована как результат. Понятно, что должно измениться после работы агента, а не только то, что он должен «помогать».
- Границы прописаны. Есть список тем и действий вне зоны агента и понятное поведение на такие запросы.
- Инструкция конкретна. В ней есть роль, тон, правила и сценарий передачи человеку, без размытых общих фраз.
- База знаний актуальна. Документы соответствуют текущим продуктам, ценам и регламентам.
- Права инструментов минимальны. Агент может только то, без чего задача не решается, а необратимые действия требуют подтверждения.
- Ключи защищены. Доступы хранятся в переменных окружения, а не в коде и не в промптах.
- Тесты на реальных запросах пройдены. Выборка включает неудобные и провокационные обращения.
- Метрики и логи настроены. Видно долю верных ответов, эскалаций и ошибок вызовов инструментов.
- Запуск в узком контуре. Первый этап ограничен темой, каналом и долей обращений.
Итоги: с чего начать своего первого ИИ-агента
Создание ИИ-агента начинается не с выбора платформы, а с одной узкой задачи, у которой есть проверяемый результат. Агент отличается от чат-бота тем, что действует: у него есть цель, инструкция, память и инструменты. Это же отличие диктует порядок работы — сначала границы и правила, потом подключения, затем тесты.
Для первого запуска разумно взять no-code платформу или готовый интерфейс вроде Yandex AI Studio и собрать реактивного агента или квалификатора. Ошибки в этих ролях дешевле, а польза — быстрые ответы по базе знаний и заявки, которые не теряются, — видна уже на пилоте.
Дальше агент развивается вместе с процессом: обновляется база знаний, уточняется инструкция, расширяются инструменты и каналы. Успех здесь меньше зависит от модели и больше от того, насколько точно описана задача и насколько строго ограничены права.
FAQ: частые вопросы о создании ИИ-агента
Можно ли создать ИИ-агента без программирования?
Да. No-code платформы вроде n8n, Flowise, Botpress и Voiceflow собираются визуально: выбираете модель, вставляете инструкцию, подключаете базу знаний и инструменты. Такого подхода хватает для агента поддержки, квалификации заявок и публикаций. Код нужен, когда логика нестандартна или агент становится частью продукта.
Чем ИИ-агент отличается от чат-бота?
Чат-бот отвечает текстом и возвращает диалог человеку. Агент получает цель и выполняет действия: ищет данные, обращается к API, создаёт записи в CRM и календаре. У него есть инструменты и цикл принятия решений, поэтому он доводит задачу до результата, а не только обсуждает её.
Какая модель подходит для первого агента?
Для старта хватает быстрой и недорогой модели, если задача ограничена ответами по базе знаний и классификацией обращений. Более сильная модель нужна для сложных сценариев с несколькими инструментами. Сравните варианты на своих реальных запросах: качество на ваших данных важнее общих рейтингов.
Нужна ли агенту база знаний?
Если агент отвечает клиентам по фактам, база знаний обязательна. Без неё модель опирается на общие представления и уверенно выдаёт неточности. В базу загружают регламенты, прайсы, описания услуг и разобранные обращения, а обновляют её при изменении продуктов и правил.
Сколько стоит запуск ИИ-агента?
Зависит от способа. На no-code платформе основные расходы — подписка и оплата обращений к модели, запуск возможен без разработчика. Разработка на коде или фреймворке добавляет стоимость инженерного времени и поддержки. Точные суммы определяются выбранной платформой и объёмом обращений.
Как понять, что агент работает хорошо?
Смотрите на долю корректных ответов, долю обращений, переданных человеку, и число ошибок вызовов инструментов. Эти метрики показывают, где проблема: в инструкции, в базе знаний или в модели. Оценивать стоит на живых запросах, а не на подготовленных примерах.